عاملهای هوش مصنوعی کجا اجرا میشوند؟
زیرساخت عاملهای هوش مصنوعی محیطی را فراهم میکند که عامل در آن کد اجرا کند، با فایل و مرورگر کار کند یا از طریق API به سامانههای سازمانی وصل شود. تیم زیرساخت باید برای این محیط اجرا مشخص کند عامل به چه منابعی دسترسی دارد، چه بخشی از کارش ذخیره میشود و پس از توقف چگونه به کار برمیگردد.
گوگل کلاد در ۲۲ اکتبر ۲۰۲۶، Agent Compute Engine را معرفی کرد و در همان اطلاعیه از برنامهٔ عرضهٔ نسخهٔ پیشنمایش در ماههای بعد خبر داد. در این معماری، ابزارهای هر عامل در یک ماشین مجازی سبک با مرز جداسازی مستقل اجرا میشوند.
سازوکار زیرساخت عاملهای هوش مصنوعی
مدل زبانی ورودی را میگیرد و پاسخ تولید میکند. یک عامل میتواند بر اساس پاسخ مدل، مرحلهٔ بعدی یک کار را پیش ببرد. برای نمونه، عامل برنامهنویسی پس از دریافت مخزن کد، فایلی را تغییر میدهد و آزمونها را اجرا میکند. انجام این مراحل به فایلسیستم و ابزارهای خط فرمان نیاز دارد.
امکانات محیط اجرای عامل…
محیط اجرای عامل هوش مصنوعی بسته به نوع وظیفه میتواند فایلسیستم، مرورگر، ابزارهای خط فرمان یا دسترسی به چند API مشخص را در اختیار عامل بگذارد. عاملی که فقط یک گزارش را از سامانهای میخواند، به مجوزهای محدودتری نسبت به عاملی نیاز دارد که بسته نصب میکند و کد تازهای را اجرا میکند.
کاربرد MicroVM در اجرای عاملهای هوش مصنوعی
MicroVM نوعی ماشین مجازی سبک است که برای کاهش سربار محیط اجرا طراحی شده است. در معماری گوگل، هر MicroVM کرنل مهمان خودش را دارد و هایپروایزر آن را از میزبان و محیطهای دیگر جدا میکند.
انتخاب محیط اجرا بر اساس وظیفهٔ عامل
برای انتخاب محیط اجرا، نوع وظیفهٔ عامل و سطح جداسازی موردنیاز را در نظر بگیرید.
- ماشین مجازی سبک برای عاملی مناسب است که کد اجرا میکند، بسته نصب میکند و به جداسازی در سطح ماشین مجازی احتیاج دارد.
- محیط ایزولهٔ سبکتر میتواند برای عاملی کافی باشد که تنها دادههای غیرحساس را از APIهای مجاز و فقطخواندنی میخواند.
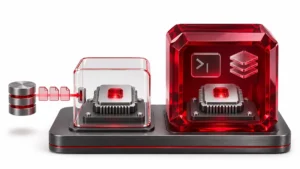
تفکیک هدایت عامل و اجرای ابزارها در Agent Compute Engine
در معماری Agent Compute Engine، هدایت عامل و اجرای ابزارها به دو بخش واگذار میشود.
- بخش هدایتکننده مدل را فراخوانی میکند، پاسخ آن را میگیرد و بر اساس این پاسخ، مرحلهٔ بعدی کار عامل را تعیین میکند.
- محیط اجرای اختصاصی کد و مرورگر را اجرا میکند و دسترسی ابزارها را به فایلها و شبکه با مجوزهای آن محیط محدود میکند.
تعلیق عامل چگونه منابع میزبان را آزاد میکند؟
عامل پس از اجرای یک ابزار ممکن است منتظر پاسخ مدل، تأیید کاربر یا نتیجهٔ یک سرویس بیرونی بماند. اگر ماشین در این فاصله فعال بماند، بخشی از حافظه و ظرفیت پردازنده در اختیار یک محیط بیکار میماند. حذف محیط هم میتواند عامل را وادار کند ابزارها را دوباره نصب کند یا وضعیت کاری را از ابتدا بسازد.
گوگل وضعیت محیط بیکار را ثبت میکند تا آن را به حالت تعلیق ببرد و با رسیدن درخواست بعدی، اجرا را از همان وضعیت ادامه دهد. با روش Copy-on-Write، ماشینهایی که از یک الگو ساخته شدهاند از صفحههای مشترک حافظه استفاده میکنند. وقتی یکی از ماشینها صفحهای را تغییر میدهد، نسخهای جداگانه برای همان ماشین ساخته میشود.
در ظرفیتسنجی عاملها، تعداد محیطهای فعال را کنار نرخ بازگشت از تعلیق بسنجید. اگر چند عامل همزمان پاسخ بگیرند، میزبان باید بتواند محیطهایشان را در همان بازه آماده کند.
معیارهای ارزیابی محیط اجرا برای عاملهای هوش مصنوعی
زمان آمادهسازی را از لحظهٔ درخواست محیط تا نخستین اجرای موفق ابزار اندازه بگیرید. سپس چند محیط را همزمان از تعلیق خارج کنید تا ببینید تأخیر ازسرگیری با افزایش درخواستها چه تغییری میکند.
| معیار | روش سنجش | کاربرد نتیجه |
|---|---|---|
| زمان آمادهسازی محیط | فاصلهٔ درخواست محیط تا نخستین اجرای موفق ابزار | اندازهگیری تأخیر شروع کار |
| زمان تعلیق و ادامهٔ اجرا | مدت ثبت وضعیت و مدت بازگشت به همان وضعیت | برآورد تأخیر میان مراحل کار |
| نرخ فعالسازی | تعداد محیطهایی که در هر ثانیه آمادهٔ اجرا میشوند | ظرفیتسنجی در اوج درخواستها |
| مصرف منابع در حالت بیکار | مصرف حافظه، پردازنده و فضای ذخیرهسازی در زمان انتظار | برآورد هزینهٔ نگهداری نشستها |
| حفظ وضعیت کاری | بررسی فایلها و وضعیت فرایند پس از بازگشت | سنجش نیاز به اجرای دوبارهٔ مراحل |
| کنترل و ممیزی | اندازهگیری زمان توقف عامل و بررسی سوابق عملیات آن | پیگیری رخدادها و اعمال سیاست دسترسی |
کارایی تعلیق و ازسرگیری در Agent Substrate
گوگل کلاد برای Agent Substrate روی Google Kubernetes Engine، بیش از ۵۰۰ عملیات تعلیق و ازسرگیری در ثانیه و زمان بازگشت محیط کمتر از ۵۰۰ میلیثانیه را گزارش کرده است. در آزمون یک زیرساخت داخلی، اندازهٔ محیط، سختافزار و الگوی درخواستها بر هر دو شاخص اثر میگذارند.
اجرای امن عامل هوش مصنوعی با هویت مستقل و کنترل شبکه
برای اجرای امن عامل هوش مصنوعی باید معلوم باشد هر درخواست را کدام عامل و با اختیار کدام کاربر یا سرویس فرستاده است. هویت مستقل کمک میکند تیم زیرساخت دسترسی همان عامل را لغو کند و عملیاتش را در سوابق پیدا کند.
در معماری گوگل، اعتبارنامهٔ سرویس هنگام خروج درخواست مجاز و بیرون از MicroVM به آن اضافه میشود. عامل میتواند سرویس را فراخوانی کند و راز اصلی سرویس بیرون از محیط اجرا بماند. در طراحی سازمانی، زمان انقضای دسترسی و شیوهٔ لغو آن پس از پایان کار هم باید مشخص باشد.
گوگل در این معماری از Agent Gateway برای اعمال سیاست ارتباطی استفاده میکند. برای نمونه، عاملی که فقط باید یک مخزن را بخواند، میتواند به همان مقصد و عملیات خواندن محدود شود. سوابق درخواستها باید نشان دهند عامل چه ابزاری را فراخوانده، درخواست به کجا رفته و چه نتیجهای داشته است.
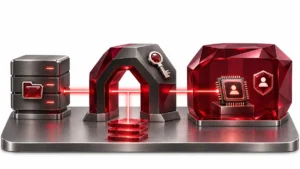
فضای کاری عامل پس از توقف چگونه حفظ میشود؟
دیسک پایدار فایلها و خروجیهای عامل را نگه میدارد. برای ادامهٔ یک فرایند از همان نقطه، وضعیت اجرا نیز باید ثبت و بازیابی شود. برای نمونه، ممکن است فایل گزارش پس از توقف روی دیسک باقی بماند، اما فرایند تولید آن برای ادامه به بازیابی وضعیت حافظه نیاز داشته باشد.
در Agent Compute Engine، گوگل دادههای موقت، فایلهای مشترکِ فقطخواندنی و فضای کاری پایدار را جداگانه مدیریت میکند. در یک زیرساخت سازمانی، سیاست نگهداری داده تعیین میکند که خروجی نهایی تا چه زمانی در دسترس کاربر بماند، فایل موقت چه زمانی پاک شود و کدام اطلاعات برای ممیزی حفظ شوند.
مجازیسازی برای هوش مصنوعی چگونه ظرفیتسنجی میشود؟
در مجازیسازی برای هوش مصنوعی، ممکن است هزار محیط تعریف شده باشد و در هر لحظه فقط بخشی از آنها مشغول اجرا باشند. نرخ ورود کار، مدت اجرای ابزارها و تعداد بازگشتهای همزمان از تعلیق مشخص میکنند میزبان در اوج بار به چه منابعی نیاز دارد.
سهمیهٔ منابع مانع میشود که یک تیم در زمان اوج، تمام ظرفیت را اشغال کند. آزمون باید نشان دهد با افزایش همزمان درخواستها، چند محیط در صف اجرا میمانند و زمان آمادهشدن آنها چه تغییری میکند.
چه چیزی را میتوان در PVM ارزیابی کرد؟
یک سناریوی پژوهشی برای PVM میتواند بار کاری هزار عامل را روی زیرساخت داخلی شبیهسازی کند. در این آزمون، گروهی ابزار اجرا میکنند، گروهی منتظر میمانند و تعدادی همزمان به کار برمیگردند. عدد هزار اندازهٔ بار آزمایشی است و ظرفیت اجرا از اندازهگیری به دست میآید. برای پیشزمینهٔ این بخش، مطلب ارزش افزودهٔ سامانهٔ مجازیسازی سرورها PVM را ببینید.
| حوزهٔ پژوهش | پرسش ارزیابی |
|---|---|
| ایجاد محیط سبک | راهاندازی هر محیط چقدر زمان میبرد و چه منابعی مصرف میکند؟ |
| الگو و تکثیر سریع | ساخت چند محیط از یک الگوی آماده در اوج بار چقدر طول میکشد؟ |
| اسنپشات و ادامهٔ اجرا | ثبت وضعیت محیط و بازگرداندن آن چقدر زمان میبرد؟ |
| مدیریت حافظه | اشتراک صفحههای حافظه چه اثری بر مصرف منابع و جداسازی دارد؟ |
| محیطهای بیکار | پس از تعلیق چه منابعی آزاد میشوند و چه دادهای باقی میماند؟ |
| هویت و ارتباطات خروجی | هویت هر عامل و فهرست مقصدهای مجاز چگونه به محیط اجرا وصل میشوند؟ |
| مدیریت اعتبارنامه | آیا میتوان اعتبارنامهٔ سرویس را بیرون از محیط نگه داشت و به درخواست مجاز افزود؟ |
| کنترل چرخهٔ عمر | ایجاد، تعلیق، ازسرگیری و حذف محیط چگونه از طریق API انجام میشوند؟ |
| سهمیه و توقف | چگونه مصرف منابع محدود میشود و توقف عامل چقدر طول میکشد؟ |
| ممیزی | آیا میتوان هر عملیات ثبتشده را به هویت عامل و نتیجهٔ درخواست مرتبط کرد؟ |
زمان آمادهسازی و بازیابی وضعیت به لایهٔ مجازیسازی مربوط میشود. کنترل مقصدهای شبکه و صدور اعتبارنامه به سرویسهای هویت و شبکه وابسته است. نتیجهٔ آزمون میتواند نشان دهد که هر قابلیت در کدام لایه باید پیادهسازی یا یکپارچه شود.
آیا پردازش لبه هم به محیط اجرای جداگانه نیاز دارد؟
در یک گره لبه، چند عامل ممکن است برای تحلیل داده یا هماهنگی فرایندها از یک میزبان مشترک استفاده کنند. اگر عامل به تجهیزات متصل است یا باید هنگام قطع ارتباط به کار ادامه دهد، انتخاب محیط اجرا به ظرفیت سختافزار، محدودیتهای بلادرنگ، ایمنی و نیاز به کارکرد آفلاین بستگی دارد.
از انتخاب محیط اجرا تا آزمون عاملهای هوش مصنوعی
انتخاب محیط اجرای عامل به نوع وظیفه و سطح دسترسی موردنیاز آن بستگی دارد. در یک پایلوت روی زیرساخت داخلی، زمان آمادهسازی محیط، مصرف منابع در حالت بیکار و تأخیر ازسرگیری در بار همزمان را بسنجید. سپس بررسی کنید که هر عامل فقط به منابع مجاز دسترسی دارد و پس از تعلیق میتواند کار را از مرحلهٔ ثبتشده ادامه دهد.